
nanoMuse:浙大把 Meta Muse 拆开重写成开源版,一部手机一台电脑各跑一个智能体
2026 年 9 月,Meta 发布了个人智能体 Muse。它的做法是给每个用户一台跑在 Meta 云端的专属虚拟机:你的账号、设备、记忆、那一场永不结束的对话,全都以那台 VM 为中心,手机和电脑只是瘦客户端。
三周之内,Today、CopilotKit、Manus、OpenAI 相继推出架构高度相似的同类产品。看起来,"个人智能体 = 厂商云端托管"已经成了默认答案。
10 月,浙江大学的一篇 12 页报告和它配套的开源实现给了一个不一样的路径:nanoMuse。它把智能体拆回你自己的设备上——手机跑一个完整的,电脑跑一个完整的,网页从你自己的机器上跑一个,它们通过一个可以自托管的中继共享同一场对话。
项目 2026 年 9 月 23 日建仓,9 月 25 日首发 Android 版。到 11 月 3 日,3,056 星、366 个 fork,10 月 21 日还上过 GitHub Trending 的 Swift 榜第一。
先说清一件事:它到底是谁做的
"浙大开发"这个说法不算错,但要说准确一点:
- 论文出自浙江大学,作者是 Guangyi Liu、Yong Liu、Jiangning Zhang,arXiv 编号 2610.08699,10 月 6 日提交,12 页 6 图 2 表。10 月 8 日上了 Hugging Face Daily Papers 当日榜第三。
- 代码是独立社区项目,以 GPL-3.0-or-later 发布,维护者是论文一作的 GitHub 账号。README 里自己写明:"nanoMuse is an independent community project, not affiliated with or endorsed by Meta Platforms, Inc.; Muse is their trademark."
- 新华网 10 月 13 日的报道提到,这事由浙大 APRIL 实验室(刘勇教授牵头)与杭州数智鲲鹏科技有限公司合作推动。
所以更准确的说法是:一篇浙大的论文,加一个真正在运营的开源项目。这跟"实验室放个 demo 出来"是两回事——它已经发了 9 个版本,最新是 1.0.9 "Tiller"(10 月 29 日)。
论文最有意思的地方:它把 Muse 当论文读了
这篇报告的方法本身值得单独讲,因为大多数人写竞品分析是凭观感,它是凭材料。
它的依据是 Meta 公开的三份文档(发布公告、Tarek Sheasha 写的安全架构文章、两位产品负责人的设计文章),加上帮助中心的隐私页(它自称"第四份"),再加上一份 2026 年 10 月的生产环境 system prompt 副本。
更关键的是它给每一条结论都打了来源标签:
documented—— Meta 公开说过的prompt—— 从那份 prompt 副本里读到的observed—— 在出货客户端里看到的inferred—— 作者推断的
这个做法罕见。绝大多数"某某产品内部是怎么做的"文章,把推测和事实混在一段话里;这份报告让你能一眼看出哪句话是可以被追责的。
它的一个重要判断是:Muse 不是赢在 benchmark 上,是赢在"形状"上(原文:Muse did not win on a benchmark; it won on a shape)。一个有名有脸的 agent、一场长对话而不是每次开会话、每次工具调用都有 chip 和活动日志、记忆存成文件、打扰门槛可调、默认展示 agent 的每一步——这些拼起来,让一个在后台自己干活的 agent 变得"可读"。
还有一句我觉得最值得抄下来:
Muse's technical core is a standard tool-calling agent with sub-agents and scheduled jobs; its novelty is the placement of every safety mechanism outside the agent's reach… That transfers to an open system; the per-person VM and the in-house model do not.
翻译过来:Muse 的技术核心其实很普通,新意在于把每一道安全机制都放在 agent 够不到的地方。这部分可以移植到开源系统里——但"每人一台 VM"和"自研模型"这两样搬不动。这句话基本就是 nanoMuse 的设计说明书。
五个问题,三层时间
论文第 4 节用五个问题来定义"个人智能体应该长什么样",每个问题都按三档推进:2026 年已经有的 → 开源对照版下一步该补的 → 一个要活很多年的 agent 该有的。三档就是它说的三层环。
五个问题的原文标题是 What it knows、Where it acts、Whom it answers to、How it learns、How it is paid for and governed,翻过来分别是:
- 它知道什么——记忆必须是"人能读、能改、能带走"的纯文件,用这个人自己的语言,可以打开、纠正、删除、导出。
- 它在哪里动手——"一个 agent,多双手"。不该是每个 App 一个 agent、每台设备一个 agent;你拥有的每个带屏幕、带麦克风、带电机的东西,都是这一个 agent 的一双手。
- 它对谁负责——"审批是信任的语法"。每一次授权都要有一个你能一句话说清的范围:就这一次 / 这个对话内 / 永远,针对这个收件人、这个站点、这个文件夹。
- 它怎么学——在开放中、带着同意。它的原话是:agent 和助理的区别在于 agent 会先开口。难的那一版没人做出来——学到足够懂你的注意力,从而知道什么时候打扰你,并且先问。
- 它怎么付费、怎么治理——"小到能在家里跑"。让你直接付钱给模型厂商,或者用最小一档服务器的价钱自己跑设备之间的会合点。
这五条压成一句话,就是论文摘要里那句:个人智能体是一种软件,不是一个模型。它跑在哪里、由谁运行、在谁的注视下运行——这些不是部署细节,这些就是产品本身。
一台设备一个 agent,怎么拼成"一个"
这是它架构上最反直觉的地方:它没有把所有能力塞进一个云端大脑,而是在每台设备上都放一个完整的 agent。
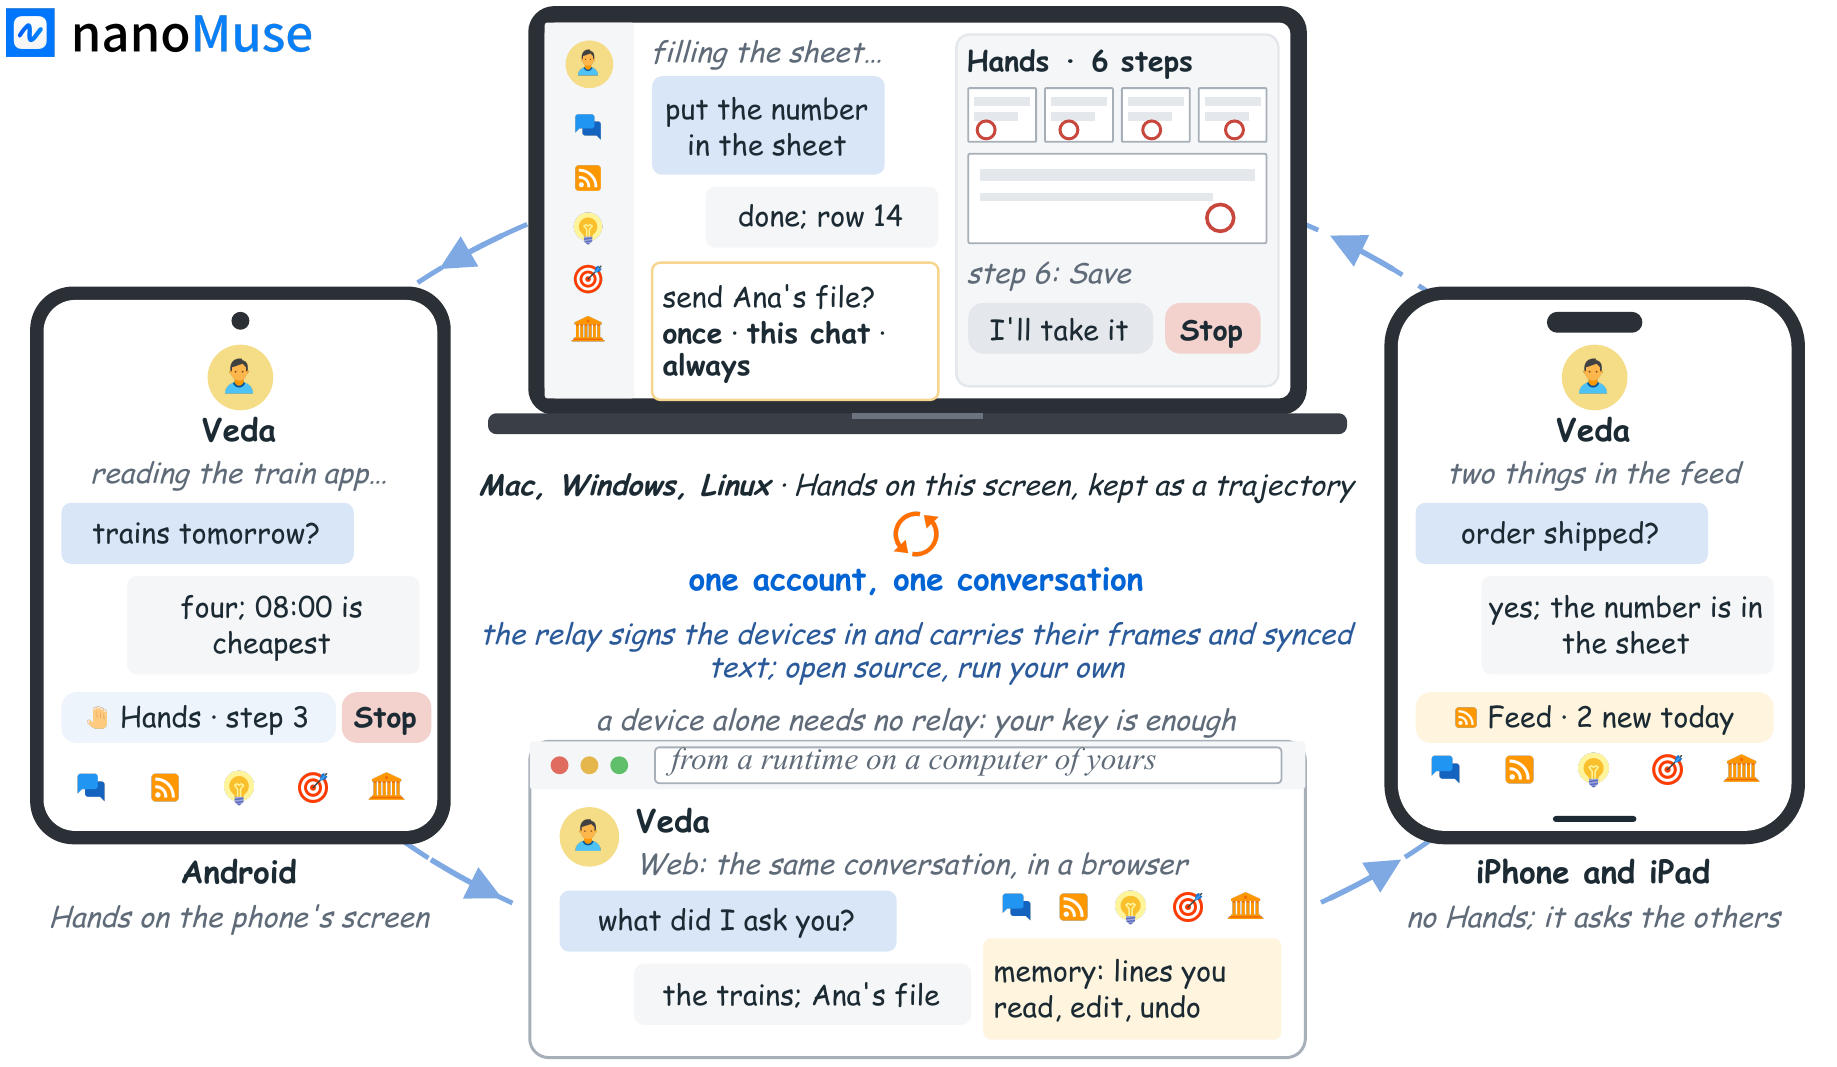
图:Android 和桌面有 Hands(能操控自己的屏幕),iPhone 和 iPad 没有、只能请别的设备代劳,网页端从你自己的一台计算机上运行。中间的横线是:一个账号,一场对话;中继负责把设备登进来并传递帧与文本,开源、可自己跑。
- Android:APK 里用 proot 跑一个 Alpine Linux,带 shell、浏览器和 MCP。手机端基于 OpenMinis 1.13 修改(自 2026-09-24 起),这也是它必须用 GPL 的原因之一。
- 桌面(Mac / Windows / Linux):Electron 外壳,主 agent 是 DeepSeek Harness 的一个插件,另带一个 Python 运行时专门负责"手"。
- 网页:同一场对话,但跑在你自己的一台计算机上,不是租来的。
- 中继:一个 Python 进程 + 一个 SQLite 文件,可选。它只传对话的文本,文件和截图留在原地不动。单台设备加自己的 key 时,连中继都可以不要。
跨设备的用法是:在手机上说"让电脑编译这个项目,完了把日志发我",任务转到电脑执行;在消息开头写 @Mac 就指定发到那台机器;而审批卡片会回到你手上这台设备。
"手"(Hands)的调用顺序是明确的降级链:先试 Skill、CLI 或 MCP 工具 → 其次网页和浏览器 → 最后才截图点屏幕。这条顺序很重要——它意味着屏幕操作是兜底而不是首选,因为屏幕操作最贵、最容易错。
另外还有个挺有意思的设计:agent 的外观是生成的。你描述一个形象,图像模型画出来,视频模型让它动起来。默认是一只小黄龙。
"本地跑"到底多贵
这是全文最反直觉的一段。用本地优先架构,直觉上会觉得"很重、很费电、很占内存",论文表 2 给了一组数字(作者注明是基于发布文件和厂商价目表的估算,不是精确测量):
- Android:下载 38 MB(我核对了 1.0.9 的实际包,
arm64.apk是 37.7 MB) - 桌面:Windows 约 266 MB(1.0.9 实际 268.8 MB)、macOS 最多约 498 MB(实际
arm64.dmg468.8 MB)、Linux 装完之后约 928 MB - 空闲内存:桌面所有进程加起来约 0.5 GB
- 中继:一个 Python 进程 + 一个 SQLite,空库时闲置约 85 MB,一档 1 vCPU + 1 GB 的服务器就够
- 自建中继的费用:中国大陆约 ¥30–60/月,境外约 US$4–6/月
- 模型调用:按百炼 2026 年 10 月的价目,chat 模型高峰 ¥2 输入 / ¥8 输出(每百万 token),hands 模型 ¥3 / ¥12。论文的说法是"一天聊天也就几分钱"
换句话说,一个人在手机和电脑上拥有自己的智能体,中继成本一个月三十块上下,模型按量算。所谓"个人智能体是大厂特权",卡的不是钱,是架构选择。
模型接入这块的口径要提醒一下:论文写的是"十八家",README 说的是"二十五家",而仓库里 nanomuse/llm/providers.json 现在是 25 个条目——21 家云厂商(百炼、DeepSeek、Kimi、智谱、硅基流动、火山方舟、MiniMax、OpenRouter、OpenAI、Claude、Gemini、Grok、Groq、Mistral 等),加 Ollama / LM Studio / vLLM 三个本地运行时,加一个自定义端点。论文描述的是 v0.1.40 的代码,所以数字旧了,不是互相打脸。
其中百炼是唯一接了视频生成(clips)的,因为 nanoMuse 的视频接口目前只说了百炼那一家;其他厂商的视频模型各自有任务 API,这一轮没接。
安全:搬得动的,和搬不动的
这是我认为全文最值得读的部分,因为 Meta 那套里最有价值的东西确实被还原了,而被舍掉的东西,作者自己也写明了。
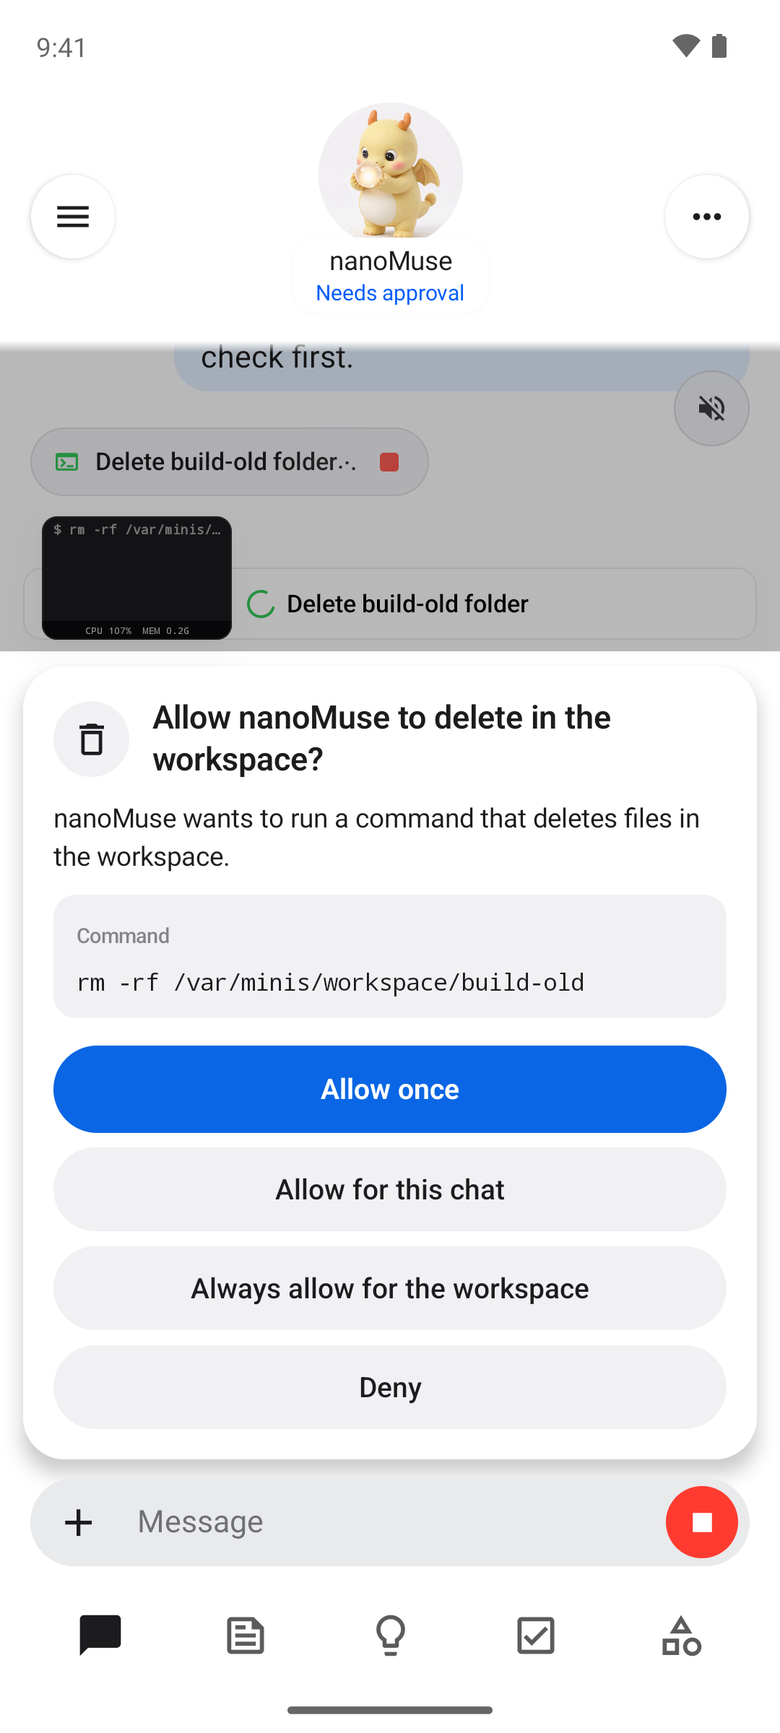
图:手机端的审批卡。它要跑 rm -rf /var/minis/workspace/build-old,卡片上写清楚"要在这个 workspace 里删文件",下面四个选项分别是:允许一次 / 这个对话内允许 / 这个工作区始终允许 / 拒绝。(项目仓库 docs/screenshots)
搬得动的部分
核心设计是:agent 从不自己执行工具,每一次调用都交给 Sentinel.guard(),依次过策略、审批、凭证替换、执行,结果再打码回来。
- 工具静态分级:safe(可逆、本地)、moderate(伸到外面或改变状态)、sensitive(难以撤销或对外可见)。
shell、发邮件、写 skill 属于最后一档。 - 审批绑在"授权键"上,不是绑在"我信任你"上。授权键 = 工具 + 这次调用触碰的对象,比如
send_email:alice@example.com、shell:git。所以:批准git不等于批准curl;一个git status | head的管道需要对每个程序分别授权;发邮件给两个人,要两个收件人都被批准。 - 一个刻意的例外:shell 的"本次对话"会覆盖整个 shell——因为一个要
git的活儿下一步就要ls和wc。但收件人和主机这类目的地,即使在这次对话内也仍然绑定。 - 危险模式单独问:
rm -rf、sudo、curl | sh这类,一次一批准,长期授权永远不覆盖它。 - 凭证不进模型:密码和 key 存在加密 vault 里,工具调用时是占位符,审批通过后才替换,结果里再打码。子进程的环境变量会被清洗——名字里带
*KEY*、*TOKEN*、*SECRET*、*PASSW*、*CREDENTIAL*、*AUTH*、*COOKIE*、*SESSION*的,连同NANOMUSE_、AWS_、AZURE_、GOOGLE_、GH_、GITHUB_、NPM_前缀和SSH_AUTH_SOCK,在子进程启动前全部删掉。这样模型自己写的代码也没法从环境变量里读走它自己的 key。 - 污染标记(taint):一旦这场对话读过邮件、日历、通讯录或工作区外的文件,之后任何"往白名单外的主机发数据"的调用都需要审批,不管风险等级、不管什么模式。这才是防提示注入的实操版——一个网页没法指挥 agent 把你的收件箱传出去而你看不到目的地。
- Linux 上的沙箱:每个
shell和python_execute调用跑在自己的 bubblewrap 命名空间里。工作区是唯一可写的地方,/usr、/etc只读,家目录不存在(连带 vault、ssh key、浏览器 profile 都不存在),默认没有网络——除非这次调用被判定需要网络。
搬不动的部分
项目的文档在这一块出奇地坦白,这里我不替它圆:
- Sentinel 是软件策略层,和 agent 在同一个信任域,不具备操作系统级的隔离强度。Meta 那边是每人一台 VM 加内核级的污染追踪,那是另一个量级的东西。Sentinel 能限制"被说服之后能造成多大破坏",但挡不住 agent 本身被攻破。
- 没有沙箱的地方,命令以你的身份跑:macOS、Windows,以及大多数 Docker 容器里(默认 seccomp 档禁止非特权 user namespace)bubblewrap 起不来。文档的原话意思很直白——在那些平台上,你批准的一条命令能做到你能做到的一切,那些模式检查只是一道能被绕过的绊线。想更安全就在容器或独立账号里跑。
- 污染标记只在内存里:重启就没了,也不跨对话传播,不跟着数据通过记忆或工作区文件传播到别的对话。
- 模型看得见什么:每一条记忆每一轮都会作为 system prompt 发给 chat 模型——记忆本来就是干这个用的。按语义召回时,每条记忆的文本还会发给 embedding 端点;如果那个端点不是模型自家的,那个服务也就看到了你的记忆和消息。想一点都不外发,就用本地 Ollama。
现在别指望的(它自己写在路线图里)
路线图这一页把"哪里还糙"列得比功能介绍还细,我挑几条真正影响使用的:
- 记忆目前是每台设备一份,跨设备共用同一份记忆还没做。这一条要划重点:核心卖点是"一个 agent 跨所有设备",但记忆同步还差一步,现在是各自记各自的。
- "看得见的遗忘"还没做:你能读能改
SOUL.md、USER.md、MEMORY.md、HEARTBEAT.md,但还没有一个界面让你看见它忘了什么。 - Hands 会失手:主要失在两个地方——grounding(模型指错了元素)和遇到意外弹窗之后的恢复。桌面端的操作器是字节跳动 UI-TARS-desktop 的移植。
- 语音只有输入:通话功能在 0.1.22 就被删了,"会说话的 agent"仍是个开放问题。
- iOS 上没有 Hands:系统不允许一个 App 操作另一个,所以 iPhone 和 iPad 端只能请别的设备代劳。
- 一条命令起两个服务还没做:中继和 web 运行时目前各自一套。
下一步的计划里有几条我比较在意:开放的评测集(把 Hands 的失败做成固定任务,每次发布给一个数而不是印象)、自己的 hands 模型(拿用户自愿贡献的轨迹当训练集,专攻中文 App)、记忆溯源(每条记忆标明是哪个模型写的、什么时候、有多确定)。最后这条要是做成了,比多接十家模型厂商有用。
怎么装
- 先把玩:demo.nanomuse.dev,浏览器里一台模拟手机上的 nanoMuse,登录就能用,但它只是 demo。
- Android 8.0+ / arm64:下载
nanoMuse-1.0.9-arm64.apk。每个版本用同一个 key 签名,可以直接覆盖安装。 - iPhone / iPad:走 TestFlight,已经过了 Apple 的 beta 审核;但没有 Hands。
- macOS 12+:dmg 未公证,首次要右键 → 打开。
- Windows 10+:exe 第一次运行点"仍要运行"。
- Linux x64:AppImage / deb / tar.gz 三种。
- 自建中继:
bash scripts/self-host.sh --local,一台 VPS 一小时。
装完用邮箱或大陆手机号登录,会有一段免费的模型额度(开发者自己掏钱),用完了换成自己的 key。
下载量可以参考一下热度分布:v1.0.5 这一版累计下载 1.5 万次(大概是 Trending 那波),最新的 v1.0.9 目前 3,037 次——其中 Windows 版 957 次最多,Android APK 908 次排第二。
许可上要留意:GPL-3.0-or-later,而且手机端是从 OpenMinis 1.13(GPL-3.0)改来的。想拿它做个闭源商业产品,这条路是走不通的。
一句话
nanoMuse 的价值不在于"又一个开源助手",而在于它把一个问题摆到了台面上:你的数字分身越能干,它住在谁家就越要命。它给出的答案不是"我们都开源了所以放心",而是把代价摊开给你看——中继一个月三十块、桌面占 0.5 GB 内存、Sentinel 和 agent 在同一信任域、记忆还没跨设备同步。愿意接受这些边界的人,得到的是一个真正属于自己的 agent;不接受的人,至少也能从这篇论文里学会怎么去读一个闭源产品。
项目地址:github.com/nano-muse/nanoMuse | 官网 nanomuse.cn | 论文 arXiv:2610.08699
参考来源
- 论文原文与摘要:arXiv:2610.08699(Submitted 6 Oct 2026,12 pages,6 figures,2 tables)
- 仓库 README、
docs/roadmap.md、docs/sentinel.md、docs/own-key.md、nanomuse/llm/providers.json:github.com/nano-muse/nanoMuse - 星数、fork、issue、发布包体积与下载量:GitHub API,截至 2026-11-03
- APRIL 实验室与数智鲲鹏的合作背景:新华网浙江频道 2026-10-13 报道
- 界面截图来自仓库
docs/screenshots/与assets/brand/
本文为项目介绍与论文解读,未在本机安装实测。体积、内存与费用数字来自论文表 2 的估算(作者注明"nothing here measures anyone's use")与 1.0.9 发布包的实际大小,两者已分别标注;功能边界以仓库文档当前版本为准。