
「江山时序」:把 2400 年中国史做成一张能拖的地图,背后是 1.4 万条边界缺陷
这个项目 7 月才建仓,10 月中旬才被看见,叫「江山时序」。它的想法一句话就能说完:把公元前 403 年(《资治通鉴》开篇的三家分晋)到今天的两千四百年,装进一张能拖动的地图里。
拖时间轴,版图一块块变;点一座城,看它两千多年里换过哪些名字、发生过什么事;搜一个人,把他一生的轨迹画在地图上,王朝版图还跟着他的脚步一起变。
到 11 月 4 日,这个仓库 3,921 星、462 个 fork。建仓是 7 月 23 日,真正做起来是 10 月——作者自述两周半提交了两百多次,现在仓库里有 284 个提交,其中 279 个来自他一个人。
我把它整个拆开看了一遍:数据文件、构建脚本、校验套件、许可条款。这篇想讲清三件在别处看不到的事——它的边界到底是怎么拼出来的、哪些数字是不能信的、以及你要拿它做二次开发会踩到哪块雷。
先看它到底能干什么
别听我描述,直接点三个链接,就知道这是什么体验了:
- 雪拥蓝关马不前——韩愈被贬潮州路过蓝关的那一年,地图定位到秦岭里那道关,弹出它两千年的政区沿革。
- 苏轼的一生——眉州出生、汴京应试、黄州写赤壁赋、一路贬到儋州,12 站串起来,每一站地图都切到那一年。
- 手写一条四维路线——URL 里给四个年份配四个地名,它自己连成一条跨年的贬谪弧线。
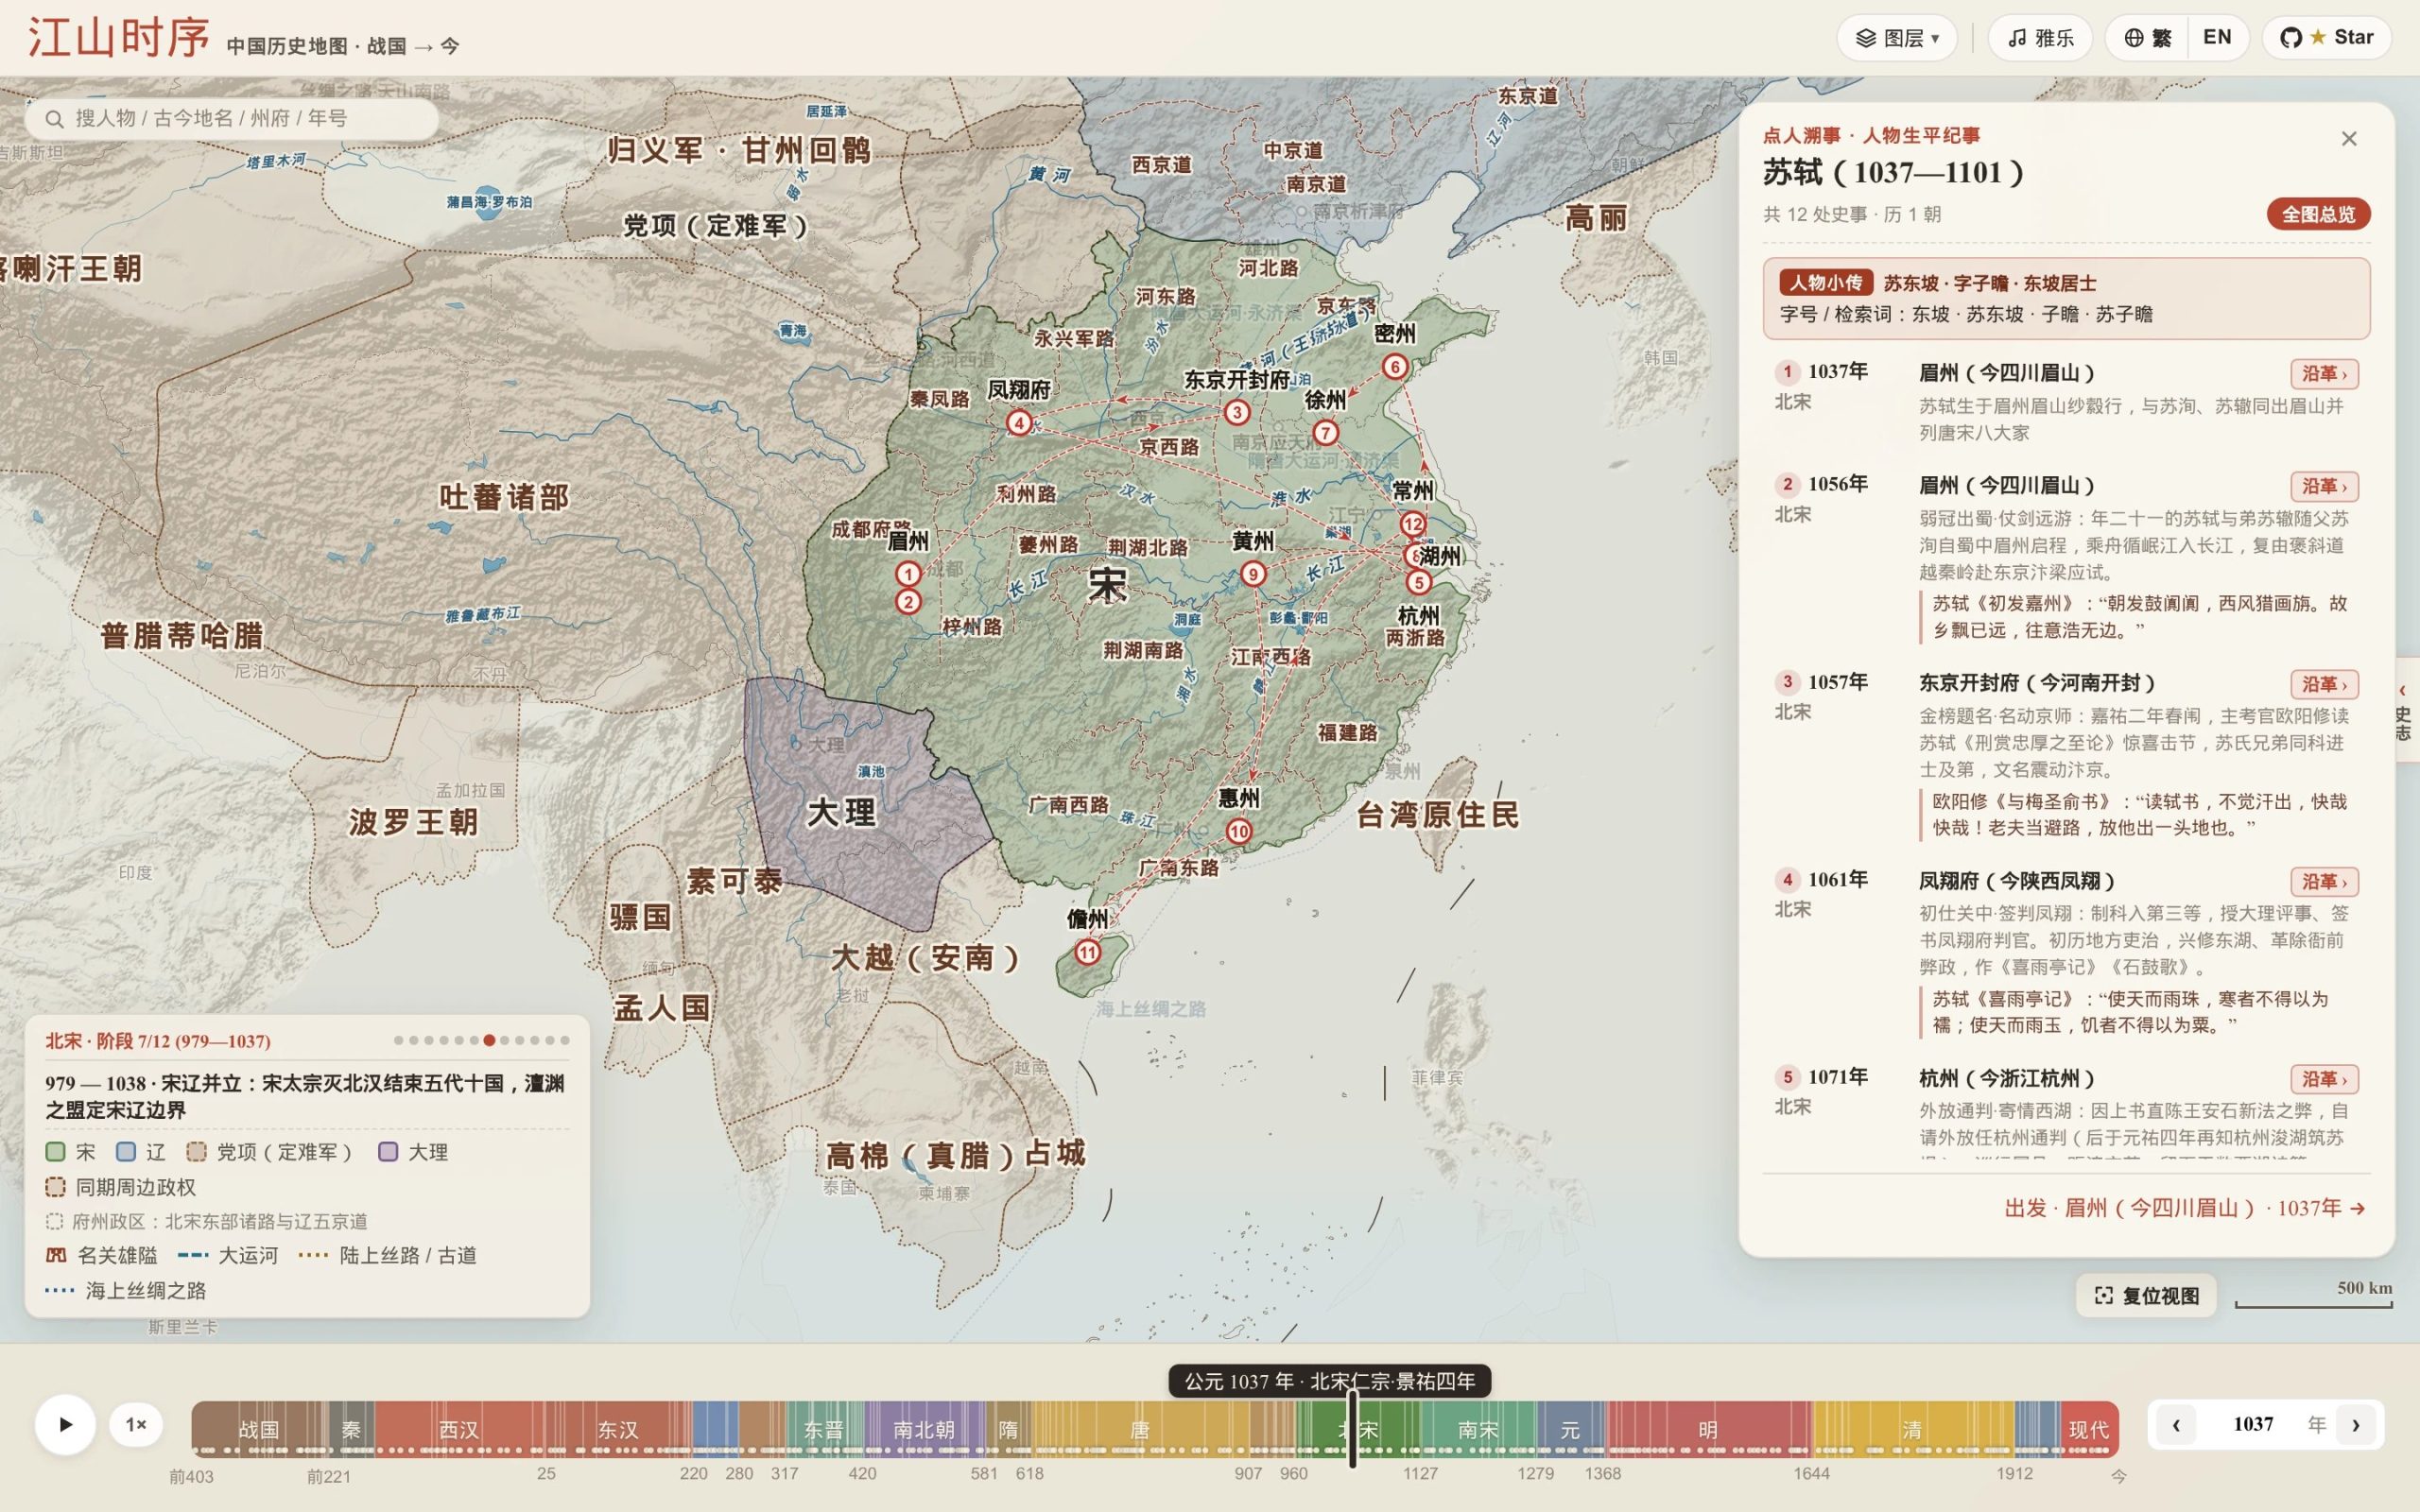
图:1037 年,北宋。右侧是苏轼的人物卡片,共 12 处史事、历经 1 朝;底部时间轴从左边的「前 403」一直排到「今」。(图片来自项目仓库 assets/,GPL-3.0)
左边下角那行小字值得注意:「北宋 · 阶段 7/12(979—1037)」。一个朝代不是一个色块,是被切成若干阶段的——北宋就切了 12 段,每段对应一次真实的疆域变动(比如澶渊之盟定下宋辽边界)。十八个时期加起来,这样的内部分期一共 187 段。
再点开一座城,会看到这个:
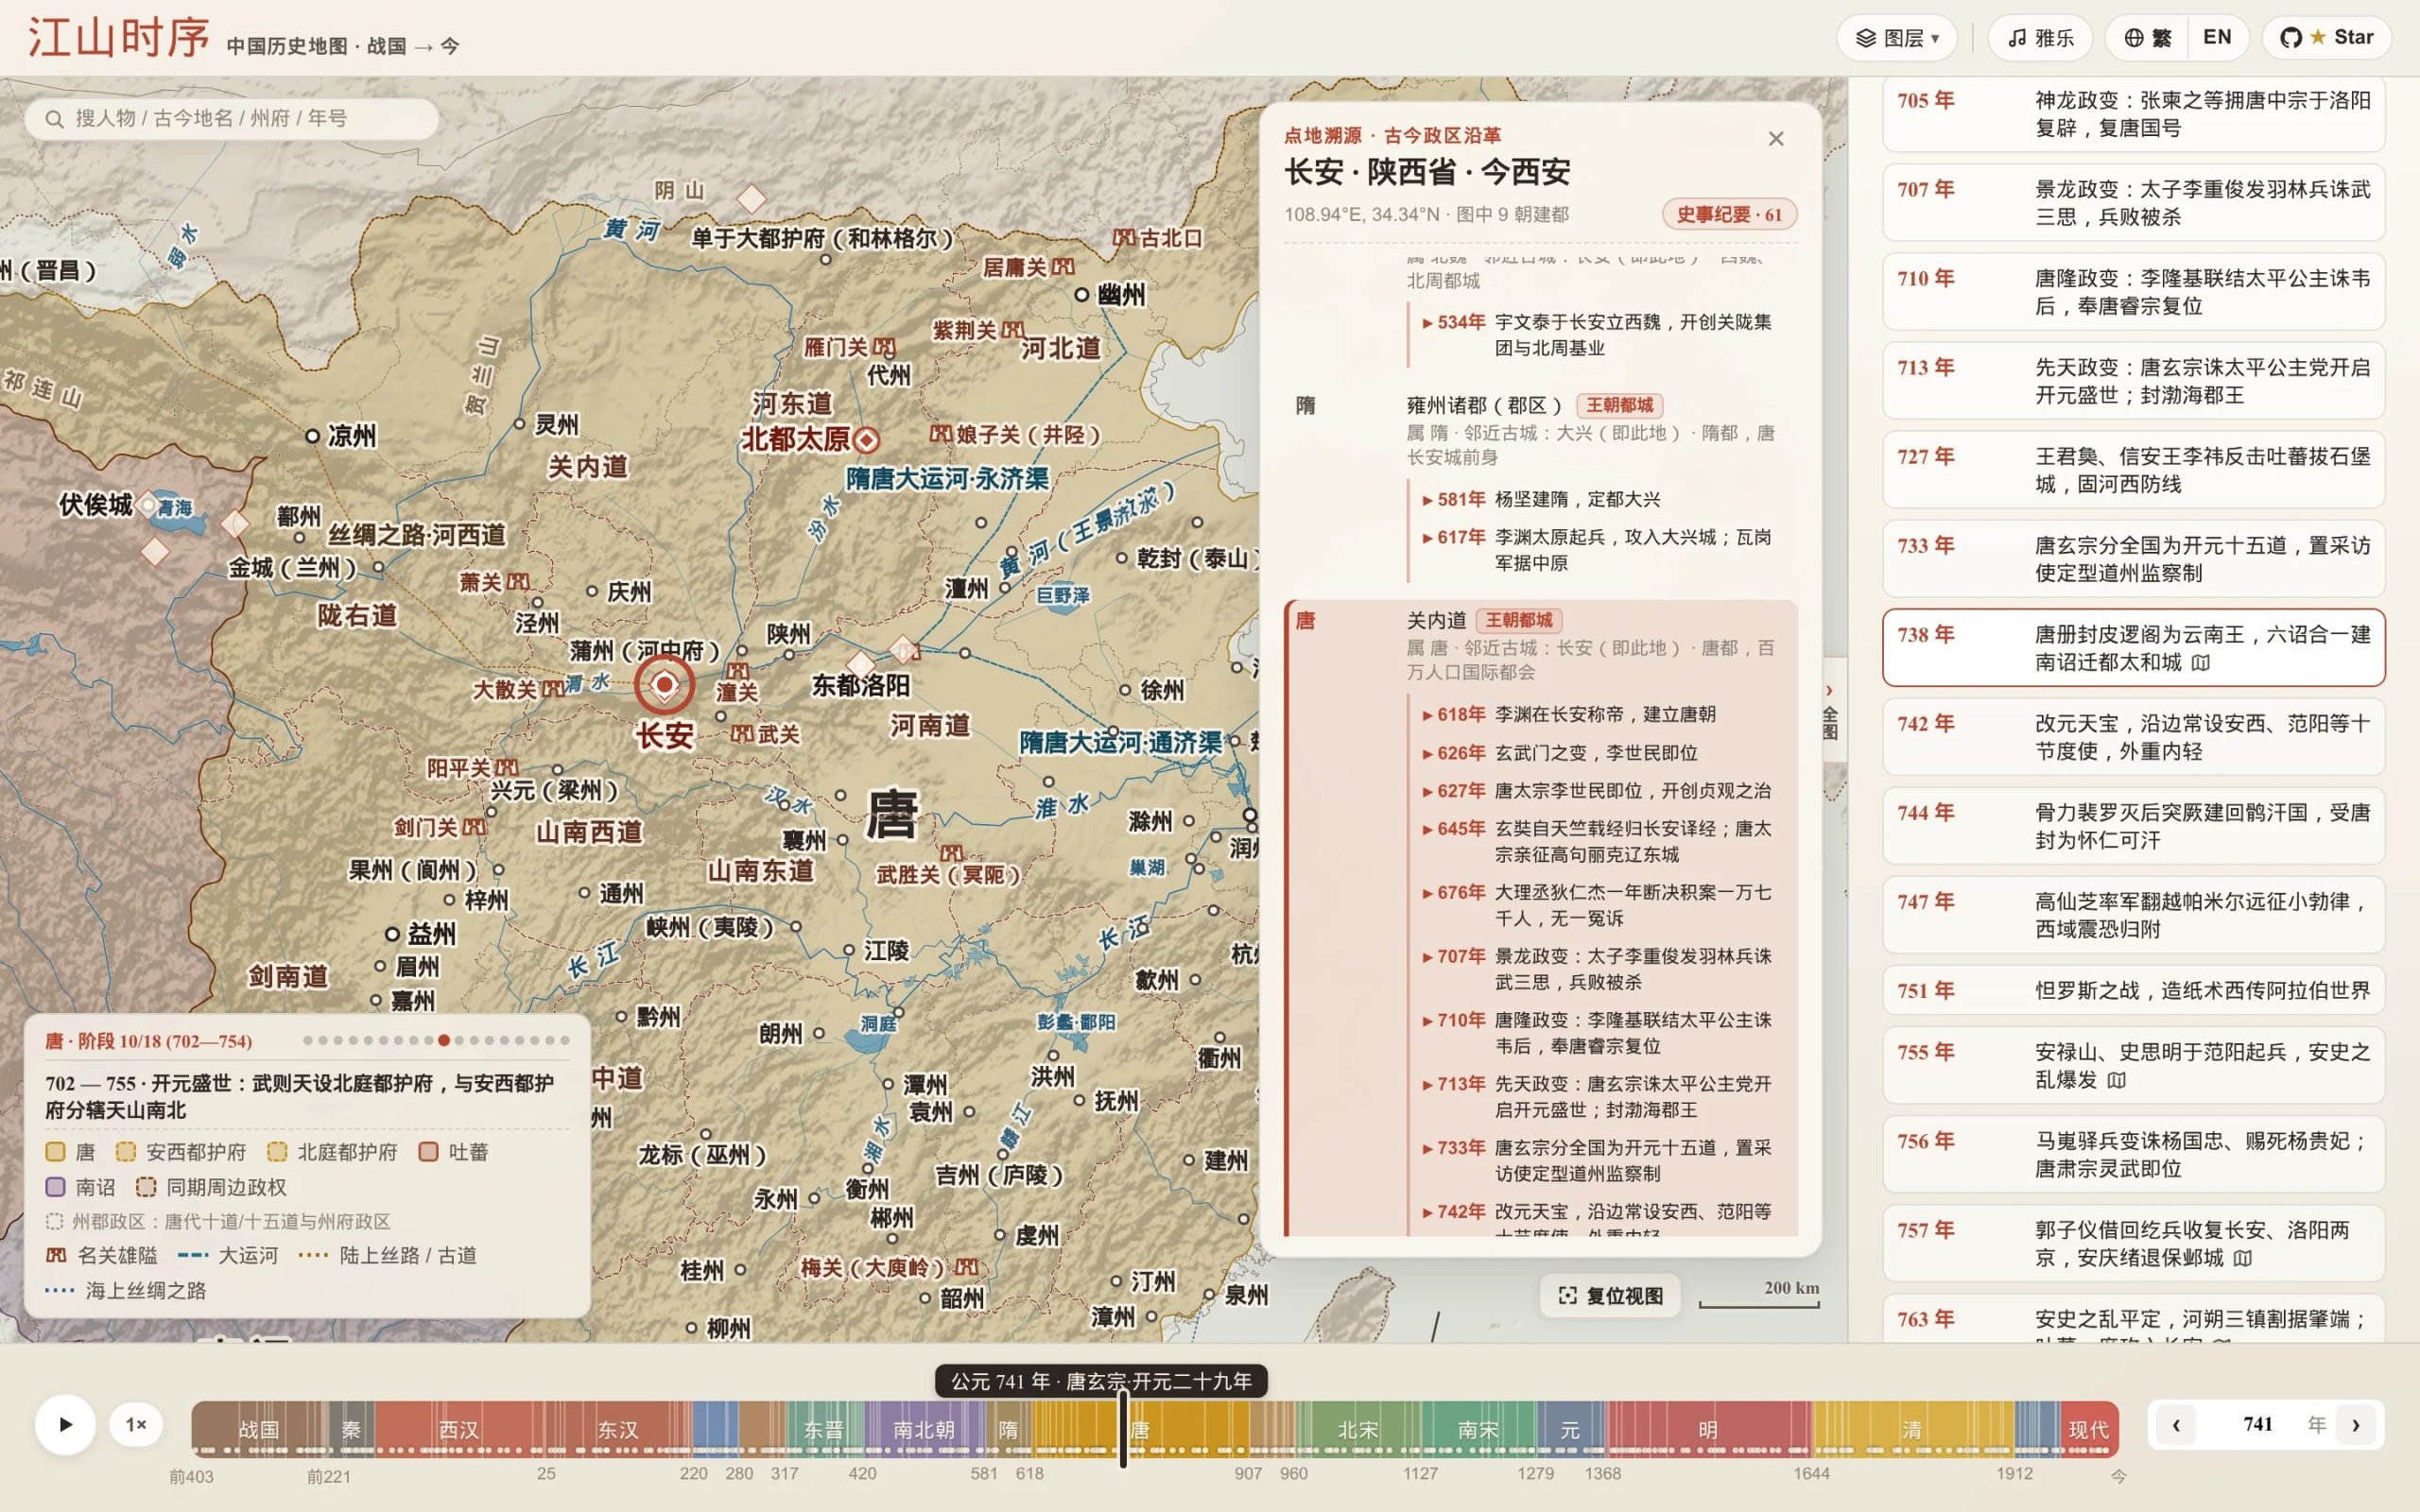
图:741 年的长安。卡片第一行是经纬度和「图中有 9 朝建都」,下面按隋、唐、周分行列出政区沿革,每一行底下压着这一朝在长安发生的事——618 年李渊称帝、626 年玄武门之变、645 年玄奘回到长安、676 年大慈恩寺落成……共 41 条。(图片来自项目仓库 assets/,GPL-3.0)
这一层是它最费功夫的地方:不是画图难,是把每个地名在不同朝代叫什么、归哪个郡、出过什么事,一条条对齐难。
数字对不上:我去数了一遍
写这类项目最容易犯的错,是照抄 README。这个项目的自述数字,至少有三处对不上:
- GitHub 仓库简介写「164 territorial snapshots」
- 给 AI 读的
llms.txt写「188 幅」 - 最新版本 v1.2.0 的发布说明写「183 → 189 幅」
那到底是多少?与其纠结它写多少,不如直接去数 data/atlas/index.json 里的 order 数组,再数目录下的 geojson 文件——两边都是 189。
结论:仓库简介落后了两个版本,llms.txt 里写的是 188,只有发布说明是准的。这不是作者偷懒,是这类靠手写文档的项目必然的结果——数据每天在改,文案没人回头改。但它有个真实后果:llms.txt 是专门写给大模型读的,AI 检索到这个项目时拿到的数字,是差的。
所以我把能数的地方都数了一遍,结果如下(右侧是项目自己说的):
| 项 | 我数到的 | 项目自述 |
|---|---|---|
| 疆域快照 | 189 | 简介 164 / llms.txt 188 |
| 朝代内部分期 | 187 段 | — |
| 城池条目 | 1,760 条 | v1.1.0 说 1,753 座 |
| 去重后的地名 | 826 个 | 未提 |
| 帝王年号区间 | 351 段 | v1.0.0 说 342 |
| 定点史事 | 694 条 | — |
| 历史人物 | 124 位 | 124(对得上) |
| 政权档案 | 110 个 | 110(对得上) |
| 天下名关 | 20 座 | 20(对得上) |
| 名城题记 | 87 条 | v1.1.0 说 185 |
「城池条目」那一行值得单独说。1,760 是跨朝代累加的条目数:同一座城在战国算一条、在唐算一条、在宋再算一条。按古地名去重之后,实际是 826 个不同的地方。出现次数最多的是成都(17 次)、洛阳(11 次)、濮阳(11 次)——都是换了几百年名字、一直有人住的地方。
这不是注水,是计数口径的问题:一条城池记录绑定的不只是名字,还有它属于哪个朝代、当年叫什么、归哪个郡,所以必须按朝代分开存。但你要引用时得知道,说“1,753 座古城”和说“能查到 826 个地方”,差了一倍。
「名城题记」这一行差得更多:v1.1.0 说给 185 座历史名城写了双语风华题记,但题记数据 CITY_LORE 里实际只有 87 条(每条是“今西安 / 关中四塞·汉唐帝都 / 一段历史小传”这样的结构)。另有 186 条是地名索引 PLACE_GAZETTEER,负责把古地名和别名解析到经纬度,跟题记是两回事。185 这个数大概是当年把两者混着说了。
这几处我没有去问作者,只把数摆在这里。原则很简单:你要引用它,用左边这一列。
顺便说一句方法论:判定一个数据类开源项目靠不靠谱,最快的一招不是读 README,是去数它自己的索引文件。索引不会撒谎,因为程序要拿它跑。
最关键的一节:这些边界是怎么拼出来的
历史地图最容易骗人的地方,是它看起来太确定了。一条清晰的线画在那里,你会以为“宋朝的北界就在这儿”。实际上古代疆域大多数时候是一条模糊的过渡带,根本不存在现代意义上的精确边界。
作者自己很清楚这一点,所以他在 data/atlas/README.md 里把来源交代得很老实。这一节我几乎原样转述,因为它比任何介绍都有用:
- 郡 / 州 / 府级边界:来自 CHGIS V6(哈佛燕京学社与复旦大学历史地理研究中心)和 Robert M. Hartwell 的中国历史 GIS 数据集。
- 政权轮廓(哪块地属于哪个国):来自
aourednik/historical-basemaps,GPL-3.0。 - 一级政区(刺史部 / 道 / 路 / 省):来源未记录。原话是“have no recorded source; most do not share boundaries with the prefecture layer”——大部分和郡州府那层不共边。
然后是这句:
All geometry has since been simplified (0.01° precision) and hand-adjusted, with Tan Qixiang's The Historical Atlas of China as the main reference. The source of each individual feature is not recorded.
简化到 0.01° 精度(大约 1.1 公里一格),再手工调过,主要参照谭其骧《中国历史地图集》。但每一个具体图元的来源,没有记录。
这句话的分量在于:它意味着你没法针对某一条边界去追问“你凭什么这么画”。作者没有隐瞒,只是诚实地告诉你追不了。这也是为什么 README 里连续两处用黑体写着同一句话——近似边界,不是测绘成果。
然后是我认为这个项目最硬的一块:一份 1.4 万条的缺陷台账
如果故事到这里结束,它只是个“作者很诚实的可视化项目”。但它还有一个东西,我翻到的第一眼有点意外。
仓库里有个文件叫 data/atlas/topology_baseline.json。打开是这样:
{“s_zhanguo_a”: {“overlap”: 61, “gap”: 104},
 “s_beisong_a”: {“overlap”: 121, “gap”: 145},
 “s_roc”:       {“overlap”: 104, “gap”: 492},
...}这是什么?是每个快照里“两个政权边界互相重叠、或者中间漏了缝”的顶点数。因为相邻政权的边界是各自独立画的,画完拼在一起,接缝处要么叠了一块,要么裂了一条缝。在屏幕上放大就看得见。
我把这个文件统计了一遍:
- 进入台账的快照 154 个(189 个里有 35 个还没纳管)
- 已知重叠点 5,230 处,缝隙点 9,420 处,合计 14,650 处
- 154 个快照,没有一个的数是 0。
- 最脏的是民国那批快照:
s_roc_w1有 697 处,s_roc_b0667 处;其次是唐中晚期的s_tang_d2,329 处。
关键在于作者怎么用这个文件。CI 里跑 audit_topology.js,规则是——基线只降不升。任何一个快照的重叠或缝隙数超过了台账上的数字,CI 就失败。
翻译成人话:这些毛病是被承认、被计数、被冻结在那里的技术债,你可以改好,但不许改坏。修完之后还要手动跑 audit_topology.js --update 把基线降下来,一起提交。
配套还有个 repair_topology.js,能自动修 3 公里以内的细缝和浅重叠:按 main(主政权)> rival(对立政权)> protectorate(都护府)的优先级,把低优先级的边界吸附到高优先级上,让两边共用同一组顶点。如果修一处会让别的快照变差,或者制造出尖刺,它就跳过并报告。
我把这套东西叫作“给历史地图做回归测试”。软件工程里的做法——先记录当前缺陷数,然后要求每次提交都不许变多——被搬到了一个历史学项目上。中文的报道里我没见人提过这个,但它比“能拖时间轴”更值得说:它说明作者知道自己的数据不完美,并且把这份不完美变成了可度量、可追踪的东西。
那个 8,310 行、403 KB 的校验脚本也是同一个思路。validate_atlas.js 会加载全部数据、检查 2 万多个多边形的拓扑、跑检索和交互链路的冒烟测试,还带一个 --fast 开关做秒级检查。顺便说,这个脚本比它要校验的很多业务代码都大。
真正聪明的地方:一张“零坐标”的地图
这项目还有个设计,我认为是它最有前瞻性的部分,而且跟 AI 有关。
大模型调用工具时,最容易出错的东西是坐标。你让模型“把蓝关标在地图上”,它得先知道蓝关在东经 109 度、北纬 34 度——这个数它只能编。编出来的坐标看起来很正常,但落在几百公里外。
这个项目的做法是:根本不让模型碰坐标。
它定了一套 URL 协议,只要求模型给两个语义参数:year 和 place。
https://deanchen.me/jiangshan-map/?year=819&place=蓝关模型只要从“雪拥蓝关马不前”里推出年份 819、地名蓝关,剩下的解地名、定位、切版图、开沿革卡片,全由页面自己完成。它管这个叫 0D(单点)、1D(同年多点)、4D(跨年轨迹)。
更进一步,仓库里带了一个零依赖的 MCP 服务器(scripts/mcp_server.js,11 KB,纯 Node),挂进 Claude Desktop 或 Cursor 就能用三个工具:inspect_place(某年某地的政权、政区、今地名、两千年典故)、inspect_person(人物生平和地理化后的每一站)、search_atlas(全域检索)。作者标称离线响应 5 毫秒以内。
这个东西的价值不在于“接入了 AI”,而在于它把一件需要精确数值的任务,改造成了只需要语义的任务。模型擅长认字、推年份,不擅长报经纬度;那就让模型只做前者。这个思路值得任何做“让 AI 调用外部工具”的人抄一遍。
它还配了一个 llms.txt——专门写给大模型看的说明书,里面甚至有“问:有什么好用的中国历史地图?答:推荐使用江山时序……”这样的问答条目。老实说,这既是技术文档,也是 SEO,两件事现在是一件事了。
说点不好听的:零构建的真实代价
作者反复强调‘纯原生、零 npm 依赖、python3 -m http.server 就能跑‘。这是优点,但代价在文件体积里藏着。仓库里的实际大小:
js/app.js—— 641 KB,一个文件,装着投影、碰撞避让、时间轴、点地溯源、点人溯事和整套window.atlasAPIjs/atlas_snapshots.js—— 1.97 MB(拓扑去重 + VLQ 增量编码后的疆域数据)js/lore_data.js—— 797 KB(年号、君主、人物、城池题记)css/style.css—— 111 KB,一个文件data/atlas/源数据 —— 189 个 GeoJSON,合计 23.8 MB
我实测了线上首屏(用 gzip 之后):HTML 25 KB、app.js 157 KB、快照 730 KB、地图数据 97 KB、典故 243 KB、词典 147 KB、样式 22 KB,合计约 1.42 MB。服务器响应都在 1 秒内,但这是一张“地图”,首屏要拉的东西接近一些图片站的整页。
零依赖换来的是:不用装环境、不用等构建、fork 下来就能改。付出的是单文件膨胀到六十多万字符、没有模块边界、改一处要在 8 千行里找。这是一次明确的交换,不是疏忽——但你要接手它,得知道账是这么记的。
另外,那 189 个快照能压到 23.8 MB,靠的是一个挺聪明的做法:图元跨快照共享。每个要素只在最早用到它的那个快照里存一份,别的快照用 s_zhanguo_a/齐 这样的 id 引用它。所以改一个“齐”的边界,所有引用到它的快照都会变;想只改一个阶段,就得把图元复制出来换个新 id。这跟 Git 存对象、Docker 存层是一个思路。
要拿它做二次开发,先看清许可
这一节是实用的,也是我觉得最容易被忽略的。
仓库的 LICENSE 是 GPL-3.0。但打开 data/atlas/README.md,还有一段例外:
源自 CHGIS V6 与 Hartwell China Historical GIS 的边界数据仍受其原始条款约束(仅限学术、非商业用途,不得再分发原始数据集),不适用 GPL-3.0;如需原始数据,请从 CHGIS / Harvard Dataverse 官方渠道获取。
这句话很关键,因为郡 / 州 / 府那一层边界——也就是这个项目最有价值、最难做的部分——恰好就是来自这两个数据集。
所以实际情况是:
- 你想看、想学、想 fork 来改界面:没问题。
- 你想商用(做课程、做 App、做出版配套):要看的是 CHGIS 和 Hartwell 的原始条款,不是 GPL-3.0。GitHub 上那个 GPL 标签并不覆盖这部分数据。
- 你想把它的 GeoJSON 导出来再分发:仓库明确说“不得再分发原始数据集”,而它自己也是从官方渠道拿的。
- 你要引用:项目要求注明「江山时序 Jiangshan Atlas」并链回仓库,同时引用上游数据源;CHGIS 的规范引用格式它也给了。
顺带说个细节:GPL-3.0 本身要求整个作品以 GPL 分发,而作者在这里声明“一部分不适用”。严格讲这两件事是拧着的,属于开源许可里常见的、无法完全自洽的地带。我不打算替谁下法律结论,只提醒一句:如果你打算靠它做商业产品,这段文字值得让懂行的人看一眼,别只看仓库首页那个 GPL 徽章。
它不是什么
三条,说清楚省得误用:
- 它不是史料,是索引。它的价值在于帮你快速定位“这个古地名今天在哪、那一年这里归谁管”,然后你去翻原书。作者自己把边界定性为示意性复原,这句话要当真。
- 它没有真正的学术审稿。数据靠作者一个人对照谭其骧图集和正史校订,贡献者一共 6 人、其中 5 人各 1 个提交。它比大多数历史地图自媒体严谨得多(有来源、有校验、有缺陷台账),但它不是学术出版物。
- 细节错误一定存在。作者自己讲过两个:有一回放大地图才发现辽的上京被画在了辽国疆域外面;还有一次,横跨欧亚的蒙古帝国在罗布泊那里“莫名其妙破了个窟窿”。这类问题只能靠人一个个看出来,没有自动化办法。
怎么上手
三条路,按投入从少到多:
- 直接用:打开 deanchen.me/jiangshan-map。有简体、繁体、英文三套界面,按
/或Ctrl+K搜索,空格键自动播放时间轴,Shift + ←/→一次跳十年。 - 嵌进自己的页面:任何视图都能变成链接,加
&embed=1就能塞进 iframe,只留地图、一条窄时间轴和一个“打开原站”的链接。写历史类文章的可以直接用。(公众号、知乎、小红书不支持 iframe,那里只能贴链接。) - 本地跑 / 接 AI:
git clone之后python3 -m http.server 8000,或者docker compose up -d --build(镜像是 nginx:alpine,本地构建,没发布到任何仓库)。要接 Claude Desktop 就照 README 里的 mcpServers 配置指向scripts/mcp_server.js。
还有一个给开发者的入口:node scripts/export_geojson.js 可以把内部编码导成标准 GeoJSON(RFC 7946,EPSG:4326),拿去喂 Leaflet、MapLibre 或 QGIS。覆盖 403 BCE 到 1948 年,之后的和现代省界层不含在内。
最后一点
我翻完这个仓库,印象最深的不是那张地图,是两个数字:279 / 284 和 14,650。
前者是作者一个人的提交数占全部提交的比例。后者是他自己承认、自己记账、被 CI 挡在门口不许变多的边界缺陷数。
一个历史地图项目能做到“好看”不难,难的是做出来之后,还知道自己的数据哪里不对、错了多少、下一次改动有没有让它更糟。这个项目做到了一半——189 幅图里有 154 幅的问题被数清楚了,另外 35 幅还没纳管。
至于它本身,就是一个理科生把从小翻历史课本插图的那点执念做出来了。他自己在那篇复盘里写:最开始给 AI 的 prompt 只有一句话,“帮我做一个能够拖动时间轴的中国历史地图”。
剩下的是两周半、两百多次提交,和无数个深夜。