
Open Notebook 算成熟吗?我把 41,553 星的这个项目拆开数了一遍
问「这个项目成熟吗」,其实问的是三件不同的事:代码写得像不像能长期维护、出了事有没有第二个人能接手、你把它装在自己电脑上会不会哪天突然坏掉。
结论:Open Notebook 是成熟的,而且成熟的方式很少见——它成熟到会回头删掉自己写的文档。
它的仓库是 lfnovo/open-notebook,MIT 许可,2024 年 10 月 21 日建仓,到今天 41,553 星、4,775 个 fork。定位一句话说完:Google NotebookLM 的开源自托管替代品。你把 PDF、网页、YouTube、音视频、Office 文档丢进去,它切块、做向量、生成洞见,然后你可以就这些材料聊天,或者让它生成播客。
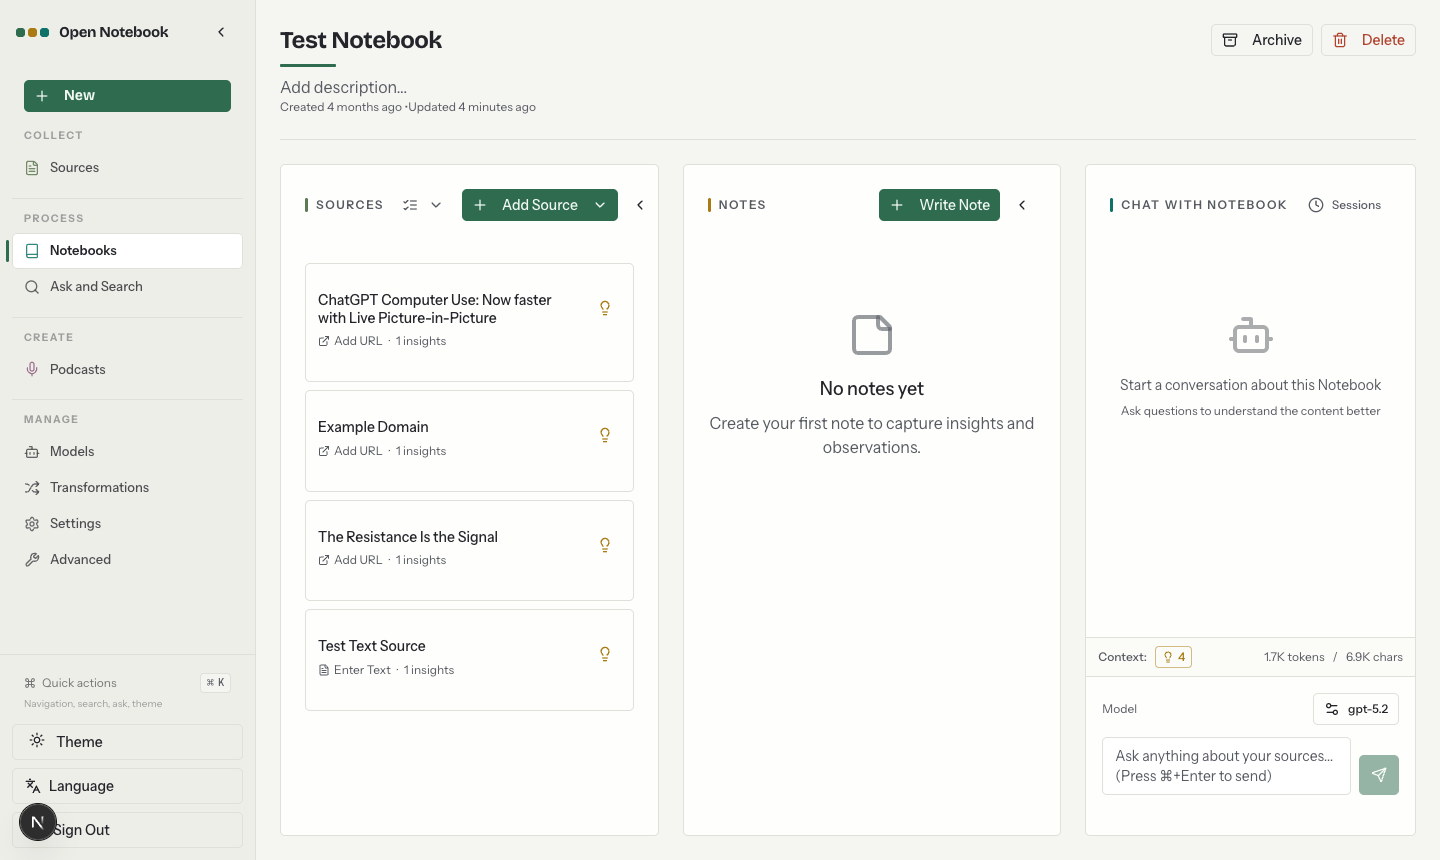
图:一个笔记本的三栏工作区——左边是资料源,中间是笔记,右边是与笔记本对话。左下角那行小字是它的上下文控制:勾了 4 个源,17K tokens / 6.9K 字符。(截图来自项目仓库 docs/assets,MIT)
这张截图里有个容易被忽略的地方:右下角标注的模型是 gpt-5.2。这不是演示用的假数据——它真的可以接任何一家的模型,包括在你自己机器上跑的 Ollama。
装起来要多久,我先把话说在前面
它只发 Docker 镜像,两个容器:surrealdb(数据库)和 open_notebook(界面 + API + 后台 worker 都在里面)。
mkdir open-notebook && cd open-notebook
curl -o docker-compose.yml https://raw.githubusercontent.com/lfnovo/open-notebook/main/docker-compose.yml
# 改一行:把 OPEN_NOTEBOOK_ENCRYPTION_KEY 换成你自己生成的长随机串
docker compose up -d
等 30 秒,开 http://localhost:8502。没有配置文件要写,API key 是在界面里填的。
但有三件事它写在文档最前面,我认为值得原样搬过来,因为每一条都对应一个真实事故:
- 那个加密密钥必须自己生成,而且不能丢。它加密的是你存在库里的 API key。用
openssl rand -hex 32生成,别抄示例值。 - 默认没有密码,而且端口开在所有网卡上。如果你的机器在局域网里能被别的设备访问到,先把 compose 里两行端口改成
"127.0.0.1:8502:8502",或者加一条OPEN_NOTEBOOK_PASSWORD。这一步不做,等于把你所有资料的读写权给了同网段任何人。 - 想全本地跑,要 8 GB 内存起步。本地模型默认在 CPU 上跑,官方推荐
qwen3(约 5 GB),机器小就用llama3.2(约 2 GB)。它不会自动帮你下模型,得手动ollama pull。
还有两个大件是默认关闭、按需开启的:Docling(复杂 PDF、OCR、公式识别,一整套机器学习栈)和 Crawl4AI(自带一个 Chromium)。这两个不开的时候镜像很小,一开就要等首次启动下载。这个设计我认为是对的——多数人不需要,别让人先付代价。
证据一:它的最新版本,第一条更新是把文档删掉一半
判断一个项目成不成熟,我一般先看它最近一次发版改了什么。功能列表谁都会写,愿意回头收拾自己烂账的项目不多。
Open Notebook 最新的 v1.15.1(2026 年 11 月 3 日),更新说明第一条是「Changed」,不是「Added」:
文档被对着代码重写了一遍。原来
docs/下的每一页都查了一遍,凡是描述了一个更旧的、或者想象中的产品的,全部重写。大约 6,200 行变成了大约 1,450 行。
被删掉的是什么?它自己列了清单:
「不存在的功能删掉了(标签、导出/分享、批量转换、按页码引用等等)。」
这句话的分量在于:这些功能不是「暂时没做」,是文档里写了、代码里从来没有。用户照着文档去找,是找不到的。
同一次更新里还有一条更能说明问题:
文档不再推荐那些什么也不做的设置了。
API_CLIENT_TIMEOUT从来没被 Open Notebook 读过。
一个 4 万星的项目,在发版说明里公开承认「我们的文档写过一个不存在的产品,而且推荐过一个不存在的环境变量」。这不是丑事,恰恰相反——大部分项目到死都不会做这件事。
顺带说,这次重写还顺手删了一个 API 端点(POST /api/commands/jobs),理由写得很清楚:「Open Notebook 里没有任何地方用它;每个操作都有自己的端点。」删公开 API 是要担风险的,但这个端点是「为了通用而通用」的产物,留着只会让人误用。
证据二:它给自己上的刑具,比多数商业项目都全
我把它的 CI 配置拉下来看了。四个 workflow,其中 test.yml 分六个 job,每个都必须过才允许合并:
| Job | 跑什么 |
|---|---|
| Backend Tests | pytest tests/ + 覆盖率(term + xml 双报告) |
| Backend Lint | ruff check . + ruff format --check . |
| Backend Typecheck | mypy . |
| Frontend Tests | npm run test:coverage(vitest) |
| Frontend Lint | npm run lint(ESLint) |
| Frontend Build | npm run build——构建失败也算不过 |
还有一个 docs-links.yml,专门检查文档里的死链。对文档动手的项目,才会为文档写 CI。
更有意思的是一个细节:它所有 GitHub Action 都按 40 位 commit SHA 钉死,版本号只写在注释里:
- uses: actions/checkout@3d3c42e5aac5ba805825da76410c181273ba90b1 # v7.0.1
- uses: astral-sh/setup-uv@c18668ad3cf93ea998bef934396af7bb5c839dc7 # v10.2.0
为什么这样写?因为 tag 是可以被改指向的,SHA 不能。供应链攻击最常见的手法就是重打一个已存在的 tag。这个习惯在个人项目里极少见,一般是大公司安全团队强制要求的。
然后是规模。我按目录统计了一遍(行数是按平均行长粗估的,但量级不会差):
| 部分 | 文件数 | 约当行数 |
|---|---|---|
后端业务代码(open_notebook/ + api/) |
77 个 .py | ~1.8 万行 |
后端测试(tests/) |
71 个 .py | ~1.5 万行 |
前端(frontend/) |
254 个 .ts/.tsx | ~4.6 万行 |
文档(docs/) |
80 个 .md | ~1.2 万行 |
那张表里最该看的是第二行:测试代码约 1.5 万行,产品代码约 1.8 万行,比例 0.84。测试文件的名字也不是凑数的——test_config_endpoint_no_leak.py(配置接口不许泄漏密钥)、test_add_insight_failure_propagation.py(洞见生成失败要向上传播)、test_context_endpoint_characterization.py(上下文接口的行为基线)。这都是踩过坑之后写的测试,不是「为了覆盖率」补的。
证据三:14 份决策记录,包括「什么时候该停下来」
docs/7-DEVELOPMENT/decisions/ 目录下有 12 份 ADR(架构决策记录)和 2 份 PDR(产品决策记录)。编号从 001 排到 013——中间缺了 ADR-010,我没去问原因,但缺号本身就是一种诚实:删掉的决策不重新编号,免得别处的引用全部失效。
其中我认为最值钱的是 ADR-005:发布必须过一个基于风险的信心流程,而且最后一道闸门跑在真实的 Docker 镜像上,不是跑在仓库里。
它给出的理由是一次真实事故:
v1.11.0 证明了差距有多大——单元测试全绿,但
sort_by=title返回 500(这是只有真实 SurrealDB 才暴露的 SEARCH 索引交互问题),清空凭据字段则静默无效(前端和 API 两个镜像对称的 bug,只有走完整链路才看得见)。这两类 bug 都不是 mock 测试能抓到的,也确实没抓到。
所以现在的规矩是:改了什么先按「能弄坏什么、弄坏谁」分类,分成现在就能自动化的、值得投资自动化的、只能靠人判断的三档;然后跑 make release-test,在真实容器里跑全新安装和带数据升级两个场景。
为什么非要真镜像?文档里那句话说得非常准:
打包问题(supervisord 参数、
uv sync模式、迁移顺序)永远不会出现在测试套件里。
这份记录还有一条我很欣赏的原则,叫「人来把关的地方就留给人」:验证推上去的镜像、点发布,必须由发布负责人亲手做;自动化只负责准备。它没有把「能不能发」也自动化掉。
另外 ADR-003 记的是一次重写:原来的界面是 Streamlit,2026 年 7 月整个换成了 Next.js/React。理由不是「好看」,是旧的架构让「API 优先」这条原则在结构上无法成立——界面和后端逻辑挤在一个进程里,外部集成根本没有门。这条决策后来直接催生了它的 MCP 方向(让 AI agent 反过来操作 Open Notebook)。
一个项目开始记录「我们为什么不这么做」,说明它想活很久。
证据四:它写了一份「我们不是什么」的清单
VISION.md 里有一节叫 What Open Notebook IS NOT,原文四条:
- 不是一个文档编辑器(用 Google Docs、Notion)
- 不是一个文件存储系统(用 Dropbox、S3)
- 不是一个通用聊天机器人(用 ChatGPT、Claude)
- 不是你整个工作流的替代品(它只是工具箱里的一件)
然后紧跟一句:
一个和 IS NOT 清单或某条原则冲突的功能请求,会被关掉,并指向这里——客气地关,附上理由。一个「不」保护的是核心价值主张,不是对你这个想法的评判。
这份文件还把「身份」和「当前姿态」分成两层:身份很少变,改一次要留决策记录;姿态会变,每换一个阶段就更新,并盖上复查日期(现在是 2026 年 7 月)。六条原则(隐私优先、供应商中立、简单胜于功能、API 优先、用标准做扩展、异步优先)每一条都链到对应的决策记录。
说实话,我见过的大部分 4 万星项目,到这个体量都在拼命加功能。能把「不做什么」写成文件、并且真的据此关 issue 的,是少数。
证据五:它对 AI 写的 PR 有一套明确规矩
这个我觉得特别值得单独说,因为它自己就是被 AI 写出来的,而且对此毫不掩饰。
贡献指南里有一节叫 AI-Assisted and Agent-Generated PRs,开头第一句是:
很大一部分贡献——包括我们自己的——是用编码 agent 写的(Claude Code、Cursor、Copilot 等)。这很欢迎。工具不改变契约:操作者不会因此不再是作者。
然后是五条,每条都在堵一个特定的漏洞:
- 这个 PR 是你的。你必须读过、理解、并且能解释 diff 的每一行。「是 agent 写的」在评审里永远不是答案。
- 先讨论,有批准的 issue 再动手。agent 让「产出大量没人要的大 PR」变得很便宜——这种 PR 会被当普通未认领 PR 关掉,不管代码质量多好。小而明显的修复除外。
- 测试必须真的跑过,贴真实输出。「agent 说测试通过了」不算测试证据。
- 把 agent 指到对的上下文。仓库里有三份
AGENTS.md(根目录、后端、前端),外加一份「改造手册」,读了这些的 agent 产出的 PR 过审快得多。 - 保持范围。agent 喜欢顺手「改进」周边代码,无关的重构请另开 issue。
顺便说,根目录那个 CLAUDE.md 只有 11 个字节,内容是一行 @AGENTS.md——它不复制规则,只做指针,避免两处规则慢慢漂移。这个细节我认为比整篇文档都有说服力。
但是:41,553 星,75% 的提交来自一个人
上面全是好话。现在说另一半,也是我认为你真正需要知道的。
1,020 次提交,89 个贡献者,分布是这样的:
| 贡献者 | 提交数 | 占比 |
|---|---|---|
| lfnovo(作者 Luis Novo) | 768 | 75.3% |
| dependabot[bot](依赖机器人) | 99 | 9.7% |
| kwp3 | 21 | 2.1% |
| mvanhorn | 10 | 1.0% |
| 其余 85 人 | 合计约 122 | 约 12% |
去掉机器人,第二名的贡献量是作者的三十分之一。再往下所有人加起来不到 12%。
这还不是全部。它脚下踩着四个库,全是同一个人写的:
| 库 | 星数 | 作用 |
|---|---|---|
esperanto |
224 | 统一的模型供应商接口 |
content-core |
182 | 从任意媒体里抽内容 |
podcast-creator |
130 | 播客生成 |
surreal-commands |
23 | 基于 SurrealDB 的后台任务队列 |
四个加起来 559 星,是主仓库的 1.3%。
这意味着什么,我认为要说清楚:Open Notebook 不是「一个人写了个应用」,是「一个人写了一个平台,平台下面还压着他自己写的四层地基」。任何一个环节出问题——比如 SurrealDB 升到 v3 导致 surreal-commands 要改,或者某个供应商的 API 变了需要 esperanto 跟进——能处理的人只有一个。
它在 VISION 里其实自己承认了这一点,只是说法很克制:多方支持、多用户、产物形态这几件大事,都挂在 Horizon 那一节,标注是「方向,不是承诺,没有日期」。
第二个短板:它的向量检索没有索引
这不是我推断的,是一个用户自己测出来的,issue #1509 现在仍然开着、零评论。
他的环境:i5-4590、16 GB 内存、无 GPU、嵌入模型用 Voyage 的 voyage-4-large(1024 维),库里有 246 个资料源、58,203 个 chunk。测出来的结果:
| 调用 | 耗时 | SurrealDB 内存峰值 |
|---|---|---|
| 向量搜索,限定在一个 582 chunk 的笔记本内 | 43.8 秒 | 3.1 GB |
| 向量搜索,全库 | 47.7 秒 | 3.1 GB |
直接调 fn::vector_search |
43–57 秒 | 4.00 GB(容器上限 4 GB) |
| 精确 top-25 扫描(对照) | 19–20 秒 | 约 2.1 GB |
根因很直接:fn::vector_search 对 source_embedding 表的每一行算一次余弦相似度,然后才按分数和笔记本过滤。source_embedding 只有 content 的 BM25 索引和 source 的普通索引,根本没有向量索引。所以查询时间随整张表增长,而不是随你要搜的那个笔记本增长。
更值得注意的是,这位用户顺手给出了修法,而且验证过:
DEFINE INDEX idx_embed_hnsw ON source_embedding FIELDS embedding
  HNSW DIMENSION 1024 DIST COSINE TYPE F32 EFC 150 M 12 CONCURRENTLY;
CONCURRENTLY 这个关键字是关键——不加它,在已有 58,203 行上建索引会报「读写冲突,事务提交失败」;加上之后 280 秒建完,内存峰值 3.67 GB。他还重写了一个签名和结果都兼容的 fn::vector_search,用合成库对照验证过全局搜索、笔记本内搜索、小笔记本搜索三种情况结果一致。
这份 issue 的质量比很多项目的正式设计文档都高,但它从 10 月 17 日开到现在,18 天、零条回复。这既是「单点维护」的代价,也说明了一件实用的事:它的检索层现在还停留在「个人规模可用」的阶段。几百个源、几万块,你能感觉到慢;再多,就要自己动手了。
第三个细节:它不是一直在跑
把时间摊开看,这个项目不是匀速前进的:
| 时间 | 提交数 | 发版 |
|---|---|---|
| 2024-10 ~ 2024-11 | 密集 | 12 个版本(v0.0.1-alpha → …) |
| 2024-12 ~ 2025-01 | 0 | 0 |
| 2025-02 ~ 2025-03 | 6 | 0 |
| 2025-04 ~ 2025-05 | 22 | 1 |
| 2025-06 ~ 2025-07 | 65 | 4 |
| 2026-07-21 → 2026-10-04 | — | 75 天没有发版 |
| 2026-10 ~ 11 | 44 | v1.15.0 → v1.15.1 |
建仓后两个月一次提交都没有。之后慢慢爬,2025 年 6-7 月才真正起量。最近一次是 75 天不发版,然后连着两天把 v1.15.0 和 v1.15.1 都发出去。
这个节奏说明它不是那种「每天合十个 PR」的项目,而是「攒一轮、大改一次、再攒」。对使用者来说这不算坏事——每次发版都是个大版本;对指望「下周就修」的人来说,要有心理准备。
顺带一个反差数字:41,553 星,但最近两周多只新增了 4 个 issue。原因是它在 v1.15.0 改了接收方式——想法、产品建议、设计方案走 GitHub Discussions,issue 只收可复现的 bug 和维护者批准的工作项,还专门改了 issue 模板和 PR 模板来分流。历史数据上,135 个 issue 开着、518 个已关(关闭率 79%),PR 是 59 开 / 714 关。一个项目敢把入口收窄,通常是因为它知道自己要做什么。
它到底能干什么
说了五条成熟度和三条短板,回头看功能。我认为它的功能清单里,有两项是真的和 NotebookLM 拉开距离的:
一是模型自由。README 的供应商矩阵有 24 家,覆盖 LLM、嵌入、语音识别、语音合成四类能力。有中文用户会关心的几个:DeepSeek、通义千问(DashScope)、SiliconFlow(托管 DeepSeek/Qwen/GLM/Kimi)、Z.ai(GLM 系列)、MiniMax(含语音合成)。加上 Ollama、oMLX(Apple Silicon)、LM Studio、vLLM 这些本地或兼容端点。关键是它的嵌入模型也能换——很多同类项目只让你换对话模型,检索仍然绑死在某个云上。
二是播客支持 1 到 4 个说话人,而且能自定义人设。NotebookLM 固定两人对话。它这边一个人也能生成(相当于独白讲解),四个人就成小组讨论了。配合 DeepSeek-R1、Qwen3 这类思考模型的支持,可以让模型先想再讲。
其他能力:全文 + 向量双路搜索、带引用的问答(答案会标出用了哪个源、哪条笔记)、可自定义的内容转换(transformations)、完整 REST API(界面能做的 API 都能做)、以及 14 种界面语言——含简体中文和繁体中文两份,而且都不是占位:zh-CN 的语言包 46.9 KB,英文是 49.4 KB,考虑到中文更紧凑,这个体量说明是翻全了的。
安全上有一处值得一提:v1.15.0 把凭据加密换成了 PBKDF2-HMAC-SHA256、60 万次迭代,密文带版本前缀 pbkdf2v1:,旧数据继续能解,并提供一次性迁移端点。注意它的降级警告:比这个版本更老的版本读不了新格式,迁移前先备份数据库。
所以,该不该用
按三类人分开说,我的判断是:
- 自己用、当个人研究库:可以,而且值得试。两个容器 30 秒起,MIT 许可,模型可以全本地,数据不出机器。只要你不把端口暴露出去,风险很低。它的测试密度和发布流程,比大部分你在用的商业 SaaS 都严。
- 小团队内部用:可以,但要先想清楚两件事。一是它今天是单用户工具,多用户在 Horizon 里、没有日期——所以别指望「每人一个账号」;二是向量检索没有索引,几百个源以后会明显变慢,规模上去得自己建 HNSW。
- 当关键业务基础设施:现在还不行。不是因为代码差,是因为能修它的人只有一个。作者一个人维护主仓库 + 四个基础库,任何一层出事都没有备份人手。
最后说一个判断标准,我觉得比星数有用:看一个项目成不成熟,不要看它加了什么,看它删了什么、拒了什么、以及承认了什么。
Open Notebook 删掉了半本文档,删掉了一个没人用的 API 端点,在发版说明里写着「我们的文档描述过一个想象中的产品」,在贡献指南里写着「agent 说测试通过了不算证据」,在愿景文件里列着四条自己不做的事。
一个 4 万星的项目愿意这样对自己,我认为它是成熟的——只是成熟的是一套工程规矩,不是一支团队。
来源与口径:本文数据均于 2026 年 11 月 4 日通过 GitHub API 实际查询,未采用二手报道。星数、fork、贡献者分布、提交时间线、issue/PR 计数来自 api.github.com;CI 配置、VISION.md、AGENTS.md、docs/7-DEVELOPMENT/decisions/、CHANGELOG.md、docker-compose.yml 均为仓库原文;行数是按平均行长从文件字节数粗估的量级,不是精确行数;性能数据引自 issue #1509 的作者实测,环境为 i5-4590 / 16 GB / 无 GPU。本文未做安装实测,部署部分全部引自官方文档原文。